这是主线研究之外的一项早期探索:外卖配送的价格,能否同时考虑骑手收益与商家偏好,而不只是由平台单方面决定?
把定价看作策略互动
论文采用 Stackelberg 主从博弈:骑手侧代理先提出报价,商家据此调整购买意愿。骑手希望订单有利可图,商家则权衡价格与到店时间。双方并非独立决策,而是在回应对方的策略。
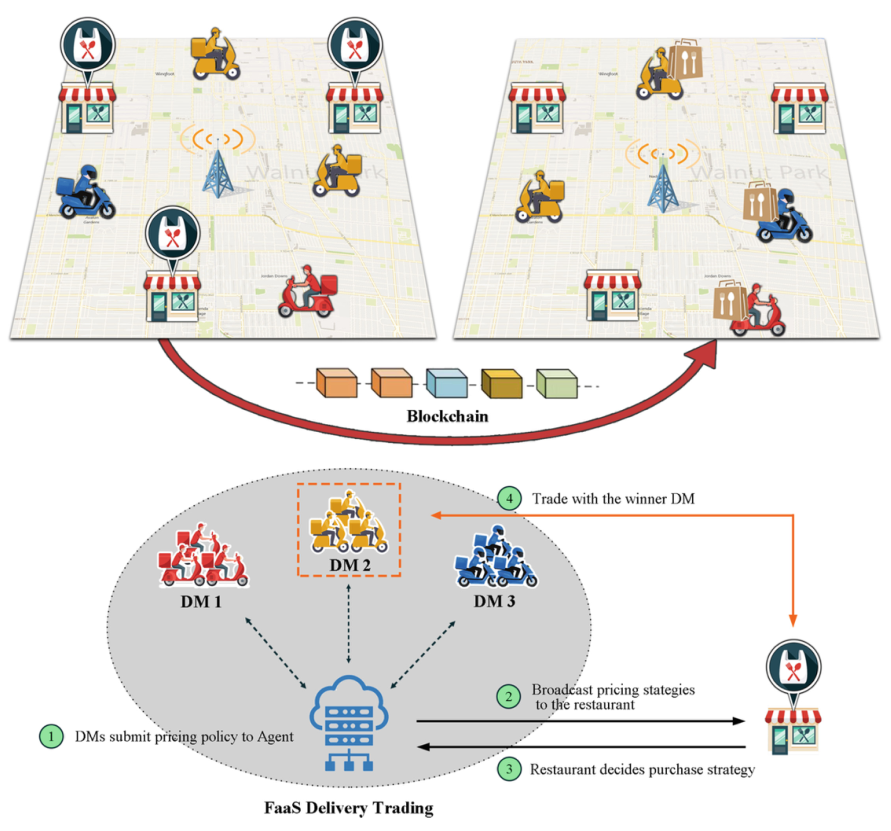
用强化学习调整报价
深度 Q 网络(DQN)根据当前价格与购买意愿,学习小幅提价、降价或维持价格。奖励来自骑手效用的变化,而非报价本身的增加:价格更高,却无人愿意购买,并不是更好的策略。
- 01观察状态当前价格与购买意愿
- 02调整报价DQN 选择小幅调价动作
- 03商家响应根据报价更新购买意愿
- 04效用反馈以骑手效用变化更新策略
两者分工明确:博弈模型描述策略关系,强化学习寻找调价策略。边缘计算与联盟链提供设想中的执行和交易记录架构,这里不展开系统细节。
结果与边界
论文考察了四名骑手的竞争场景及连续 100 笔订单仿真。在给定模型下,考虑竞争关系的方案比独立定价基线更稳定,到店更快的骑手也更容易获得订单。
这是一项基于简化仿真的概念验证,不能直接证明真实平台上的交易公平性。真实订单、差异化配送要求与跨平台竞争仍需验证。值得保留的思路是:当环境中的其他参与者也会回应你的策略时,如何把学习与策略互动结合起来?